Saturs
Ievads
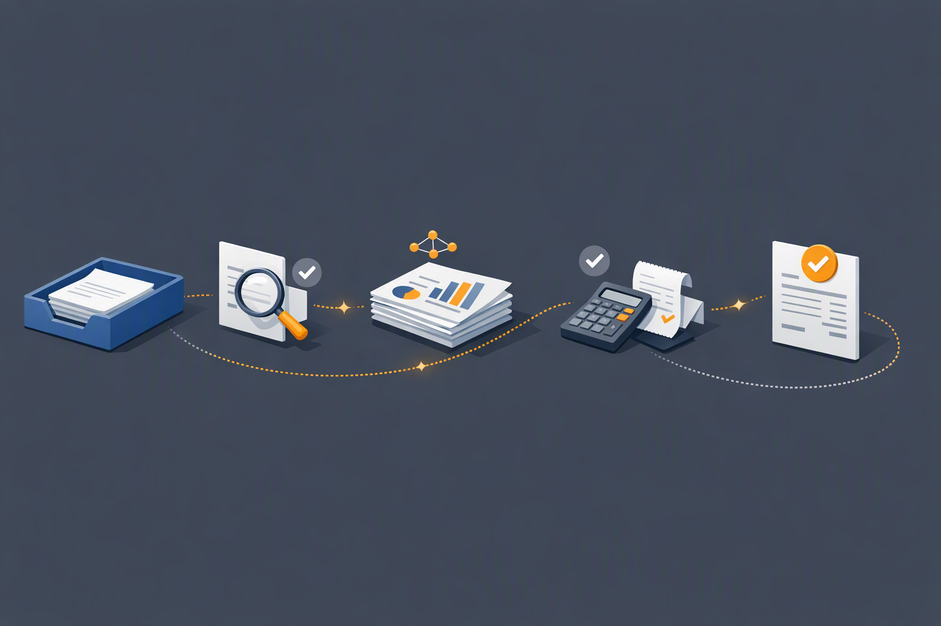
Finanšu komandā rēķinu plūsma bieži apstājas nevis pie paša maksājuma, bet pie dokumenta apstrādes: viens fails ir skenēts, otrs atnāk ar neskaidru izkārtojumu, trešais prasa manuālu datu pārrakstīšanu. Tieši tur rēķinu procesi zaudē ritmu. Mākslīgā intelekta dokumentu apstrāde šai problēmai pieiet praktiski: tā nolasa galvenos rēķina laukus, atpazīst tipiskos elementus un nodod datus tālākai validācijai un apstiprināšanai [1]. Ja organizācijā jau tiek lietots Power Automate vai Power Apps, rēķinu apstrādes modelis iekļaujas esošajā Microsoft 365 darba plūsmā bez jaunas manuālas starpposma darbības [1]. Šāds risinājums ir noderīgs nevis abstrakti “automatizācijai”, bet konkrētam mērķim: lai finanšu vadītājs redzētu, kur dokuments iekrīt, kuram laukam trūkst datu un kurš solis jānostiprina ar noteikumu, nevis ar cilvēka atcerēšanos. Turklāt veselības aprūpes scenārijā Microsoft dokumentācija AI saista ar datu ieguvi, kategorizēšanu un validāciju, kas precīzi parāda to pašu mehānismu arī rēķinu plūsmā: saņem, nolasa, pārbauda, virza tālāk [2].
Kāpēc rēķinu plūsma apstājas pie dokumenta, nevis pie apmaksas
Rēķinu procesi apstājas pie dokumenta brīdī, kad finanšu komandai pirms grāmatošanas jāizlabo pati ievade, nevis jāapstiprina saturs. Tipiskā kļūda ir vienkārša: viens rēķins pienāk kā skenēts attēls, cits kā foto no telefona, trešais kā PDF ar vairākām lapām un nevienā formātā nav vienāda lasāmība. Tad cilvēks kļūst par starplāni starp e-pastu, failu un ERP, jo informāciju pārraksta manuāli, pārbauda rēķina ID, datumu, summu un maksājuma detaļas, un tikai pēc tam dod tālāk apstiprināšanai. Iepriekš izveidotais rēķinu apstrādes modelis tieši šeit palīdz, jo tas iegūst galvenos rēķinu datus un ir optimizēts parasto rēķina elementu atpazīšanai [1].
Cēlonis parasti nav “slikts AI”, bet nesakārtots dokumenta ievades punkts. Ja vienā plūsmā sajaucas skaidrs PDF, neskaidrs foto un daļēji apgriezts skenējums, modelis saņem nevienmērīgu materiālu un cilvēks pēc tam labo kļūdas manuāli. Tāpēc risinājums sākas nevis ar automatizācijas loģiku, bet ar dokumenta disciplīnu: viens fails, viena pamatversija, skaidrs formāts un paredzams izmērs. Microsoft dokumentācija par rēķinu apstrādes modeli iesaka katram rēķinam iesniegt vienu skaidru fotoattēla vai skenējuma versiju, izmantot JPEG, PNG vai PDF, kā arī ievērot faila un attēla robežas [1].
Praktiskā sakārtošana sākas ar trim kontroļu punktiem:
- pieņem tikai vienu rēķina eksemplāru, nevis vairāku attēlu kolāžu;
- nosaki, ka ievade nāk kā JPEG, PNG vai PDF [1];
- pirms tālākas apstrādes pārbaudi, ka skenējums ir skaidrs un teksts nav sasvēries vai izplūdis.
Ja šie nosacījumi netiek sakārtoti, automatizācija sākas ar cilvēka labošanas darbu. Rezultātā apstiprināšanas ķēde kļūst lēnāka, jo katrs negaidīts formāts rada manuālu pārbaudi pirms datu ieguves. Ja ievades punkts ir sakārtots, nākamais solis kļūst mehāniski vienkāršs: pieslēgt iepriekš izveidoto modeli un ļaut tam nolasīt rēķinu laukus bez papildu pārrakstīšanas. Tas ir tieši tas brīdis, kur sākas otrais solis.
1. solis: sakārto ievades formātu, lai AI nolasa vienu skaidru rēķinu
Tipiskā kļūda praksē ir nevis pats dokuments, bet tas, kā tas nonāk sistēmā. Finanšu komanda bieži saņem e-pastu ar piesaistītu attēlu, pārsūtītu PDF un papildus telefonu foto, un visus šos avotus grib apstrādāt vienā plūsmā. Tad rēķinu procesi kļūst trausli, jo AI saņem dažāda kvalitātes materiālu vienā un tajā pašā kontroles punktā. Sakārtošana nozīmē nevis “skaistāku failu”, bet vienu skaidru rēķina versiju, ko modelis nolasa bez liekas interpretācijas [1].
Kāpēc šī kļūda rodas? Tāpēc, ka dokumentu ienākšana parasti sākas ārpus finanšu sistēmas: piegādātājs atsūta to, kas viņam ir pa rokai, bet uzņēmuma pusē vēl nav definēts, kurš formāts tiek pieņemts kā galīgais. Ja to neatrisina, vienas un tās pašas rindas nonāk vairākos izpildījumos: foto, skenējums, eksportēts PDF. AI modelim tas nozīmē papildu troksni, savukārt lietotājam — manuālu salīdzināšanu. Microsoft dokumentācija norāda, ka labākajiem rezultātiem katram rēķinam iesniedz viena skaidra fotoattēla vai skenējuma versija un ka atbalstītie attēla formāti ir JPEG, PNG vai PDF [1].
Precīza konfigurācija šajā posmā ir jāuzliek kā ievades noteikums, nevis kā “ieteikums”. Darbību secība izskatās šādi:
- definē vienu pieņemtu ievades tipu finanšu procesam;
- pārbaudi, ka rēķina fails ir JPEG, PNG vai PDF [1];
- pārliecinies, ka dokumentā ir viena skaidra versija, nevis salipināti vairāki skati [1];
- ja dokuments ir skenēts, sūti to tālāk tikai tad, kad teksts ir salasāms bez manuālas labošanas.
Ja šo soli neizlabo, automatizācija pārvēršas par daļēju atpazīšanu: daļa lauku ienāk automātiski, daļa paliek cilvēkam. Tieši tāpēc šis posms jāuztver kā kvalitātes vārti, nevis kā tehniska formalitāte. Kad ievade ir sakārtota, nākamais loģiskais solis ir pieslēgt pašu rēķinu apstrādes modeli un pārslēgt darbu no faila uz datu ieguvi.
2. solis: pieslēdz iepriekš izveidoto rēķinu apstrādes modeli
Šeit noder divu pieeju salīdzinājums. Pirmā pieeja ir manuāla apstrāde: darbinieks atver dokumentu, nolasa datus un pārraksta tos sistēmā. Otrā pieeja ir iepriekš izveidotais rēķinu apstrādes AI modelis, kas iegūst galvenos rēķinu datus un ir optimizēts parasto rēķina elementu atpazīšanai, piemēram, rēķina ID, rēķina datuma un maksājamās summas noteikšanai [1]. Manuālā pieeja der tikai situācijās, kur dokumentu ir maz un katram nepieciešama īpaša interpretācija. AI modelis der tur, kur ienākošajiem rēķiniem atkārtojas struktūra un vajadzīga konsekventa lauku izvilkšana.
Kad katra pieeja ir piemērota? Ja dokumentu apstrādē dominē nestandarta pielikumi, līgumi vai korekciju vēstules, tad rēķinu apstrāde jāsadala atsevišķos posmos. Ja tiek apstrādāti standarta piegādātāju rēķini, iepriekš izveidotais modelis kļūst par pirmo filtrējošo slāni. Microsoft dokumentācija skaidri norāda, ka modelis atbalsta lietošanu Power Apps un Power Automate, tātad tas ir domāts integrācijai plūsmā, nevis izolētai pārbaudei vienā ekrānā [1].
Ieteikums ir vienkāršs: šo soli uzstādi kā datu ieguves slāni starp dokumentu un biznesa procesu. Praktiskais izpildījums ir šāds:
- Power Apps izmanto, ja gribi, lai lietotājs augšupielādē rēķinu un uzreiz redz nolasītos laukus [1];
- Power Automate izmanto, ja rēķins pienāk kā daļa no automatizētas plūsmas un pēc atpazīšanas jānotiek tālākai darbībai [1];
- iepazīsti noklusējuma modeli pirms pielāgota modeļa izveides, jo noklusējuma darbība jau izgūst galvenos rēķina datus [1].
Ja izmanto tikai manuālo ceļu, katrs rēķins paliek kā individuāls darbs. Ja pieslēdz modeli, finanšu komandai mainās darba loģika: tā vairs nepārraksta datus, bet pārbauda, vai modelis nolasīja pareizo informāciju. Tas sagatavo augsni nākamajam solim, kur jāpārbauda konkrēti lauki un jāsaprot, kas tieši ienāk automātiski un kas paliek kontrolei.
3. solis: pārbaudi, kuri lauki tiek iegūti automātiski
Lai rēķinu procesi tiešām strādātu, nepietiek ar modeli “pievienots” statuss. Jāpārbauda, kuri lauki ienāk automātiski, jo tikai tad finanšu komanda redz, cik lielu daļu no dokumenta nolasīšanas sistēma reāli paņem uz sevi. Microsoft dokumentācija par iepriekš izveidoto rēķinu apstrādes modeli norāda, ka tas var izvadīt laukus InvoiceId, InvoiceDate, DueDate, InvoiceTotal, AmountDue un PaymentDetails, tostarp IBAN, BankAccountNumber, BPayBillerCode, BPayReference un SWIFT [1].
Praktiskā pārbaude jāveic tieši modelī, nevis pēc sajūtas. Vispirms atver Power Apps vai Power Automate plūsmu, kur modelis jau ir pieslēgts. Pēc tam palaid testa rēķinu un salīdzini nolasītos laukus ar avota dokumentu. Jāskatās ne tikai uz to, vai vērtība ir nolasīta, bet arī uz to, vai tā atbilst pareizajai rindai un pareizajam saņēmējam. Īpaši svarīgi ir pārbaudīt rēķina identifikatoru, datumu, samaksas termiņu un kopējo summu, jo tie ir tie lauki, kas tālāk ietekmē grāmatošanu un maksājuma sagatavošanu [1].
Precīzs pārbaudes ceļš finanšu komandai izskatās šādi:
- atver Power Automate plūsmu vai Power Apps risinājumu, kur ir pieslēgts rēķinu modelis [1];
- palaid vienu testa rēķinu ar skaidru ievadi [1];
- pārbaudi, vai tiek aizpildīti InvoiceId, InvoiceDate, DueDate, InvoiceTotal, AmountDue un PaymentDetails [1];
- salīdzini iegūto rezultātu ar sākotnējo dokumentu un atzīmē neatbilstības;
- ja nepieciešams, ievieto papildu apstiprināšanas soli pirms maksājuma nodošanas.
Biežākā kļūme šajā posmā ir pārbaudīt tikai to, ka “kaut kas ir nolasīts”, nevis to, ka nolasītais lauks ir pareizs un konsekvents. Tieši šeit atklājas, vai iepriekšējie soļi bija sakārtoti pareizi: ja ievade bija tīra un modelis pieslēgts pareizi, lauku pārbaude kļūst par īsu kvalitātes kontroli, nevis par manuālu pārrakstīšanu. No šī punkta loģiski pāriet uz nākamo soli — pilnīgu automatizēto datu ieguvi un tās sasaisti ar apstiprināšanas plūsmu.
Rēķinu procesi pēc datu ieguves: validācija un izņēmumu apstrāde
Validācija šajā posmā nozīmē vienkāršu, bet stingru principu: pēc tam, kad AI ir nolasījis rēķina laukus, finanšu komanda nepāriet uz grāmatošanu uzreiz, bet pārbauda, vai iegūtie dati atbilst pašam dokumentam. Tas ir svarīgi, jo iepriekš izveidotais rēķinu apstrādes modelis ir domāts galveno rēķinu datu iegūšanai, nevis aklai apstiprināšanai [1]. Ikdienā izņēmumi parādās tad, kad viens piegādātājs iesniedz skaidru PDF, bet cits ieliek skenētu attēlu ar sliktu kontrastu, vai arī rēķinā ir divi datu avoti: redzamais teksts un piezīmes kājenē. Tad procesam jāspēj atšķirt to, ko modelis nolasa automātiski, no tā, ko pārbauda cilvēks.
Praktiska pieeja sākas ar lauku salīdzināšanu. Dokumentā jāpārbauda šādi punkti:
- InvoiceId sakrīt ar piegādātāja rēķina numuru.
- InvoiceDate atbilst dokumentā redzamajam izrakstīšanas datumam.
- DueDate sakrīt ar apmaksas termiņu.
- InvoiceTotal un AmountDue atbilst summām dokumenta kopsummā.
- PaymentDetails satur pareizu IBAN vai citu maksājuma norādi, ja tā ir norādīta.
Ja kāds no šiem laukiem nav nolasīts vai neatbilst, izņēmums jānovirza atpakaļ pārbaudei, nevis jāliek grāmatvedības rindā ar pieņēmumu, ka “gan jau viss ir pareizi”. Tieši šeit rēķinu procesi kļūst droši: AI veic pirmo atlasi, cilvēks apstiprina riskantos gadījumus. Ja avotfailam nav viena skaidra fotoattēla vai skenējuma versija, validācija vienmēr kļūst smagāka, jo modelis strādā ar neviendabīgu ievadi [1].
Rezultātā komanda saņem skaidru darbplūsmu: AI nolasa, sistēma pārbauda, cilvēks apstiprina tikai izņēmumus. Tas samazina manuālu pārrakstīšanu un uztur vienu datu versiju pirms grāmatošanas. Nākamais solis ir ielikt šo pašu loģiku Microsoft plūsmā, lai pārbaude notiek automātiski, nevis e-pastos vai atsevišķās Excel darbībās.
4. solis: ievieto modeli Power Automate vai Power Apps plūsmā
Praksē šis solis sākas brīdī, kad finanšu komanda pārstāj apstrādāt rēķinus kā atsevišķus failus un sāk apstrādāt tos kā notikumu plūsmu. Piemēram, rēķins ienāk SharePoint dokumentu bibliotēkā, un tālāk nevienam nav jāatver fails manuāli, lai piefiksētu datus. Tieši šeit rēķinu apstrādes modelis iedarbojas Power Automate vai Power Apps vidē, jo Microsoft dokumentācijā ir norādīts, ka modelis atbalsta lietošanu abos rīkos [1].
Kas tiek mainīts? Vispirms tiek definēts ievades punkts. Power Automate plūsmā tas ir ieraksts bibliotēkā, e-pasts vai cits notikums, kas iedarbina modeli. Pēc tam seko darbība ar iegūtajiem laukiem. Power Apps scenārijā lietotājs dokumentu nosūta no formas vai mobilās lietotnes, un rezultāts tiek parādīts tajā pašā saskarnē. Šāda pieeja noņem starpposmu, kur failu kāds atver lokāli, pārraksta datus un tikai tad nodod tālāk.
Konkrēts darba izkārtojums izskatās šādi:
- Atver Power Automate un izveido plūsmu no trigera, kas reaģē uz ienākošu dokumentu.
- Plūsmā pievieno AI Builder darbību ar rēķinu apstrādes modeli.
- No modeļa izvades nolasi InvoiceId, InvoiceDate, DueDate, InvoiceTotal, AmountDue un PaymentDetails, ja tie ir pieejami [1].
- Pievieno nosacījumu, kas atdala pilnus datus no izņēmumiem.
- Ja dati sakrīt, saglabā tos SharePoint sarakstā, Dataverse tabulā vai nodod tālāk grāmatvedības procesā.
Rezultātā cilvēks strādā ar jau strukturētu informāciju, nevis ar pielikumiem un manuālu pārrakstīšanu. Power Apps gadījumā līdzīgu loģiku ieliek lietotāja ekrānā, lai dokumentu pievienošana un pārbaude notiek vienā vietā. Tas sagatavo nākamo soli: ja uzņēmumā ir vairāki piegādātāji ar savu rēķina formātu, standarta modelis nav pēdējais punkts, un tad jāveido pielāgotais modelis.
Rēķinu procesi ar pielāgotu modeli specifiskiem piegādātājiem
Problēma sākas tad, kad viens un tas pats rēķinu process sastopas ar piegādātājiem, kuru dokumenti strukturāli atšķiras. Standarta rēķina modelis ir optimizēts parasto elementu atpazīšanai, piemēram, rēķina ID, datuma un maksājamās summas [1]. Tas palīdz plašā scenārijā, bet specifiskam piegādātājam bieži ir savi lauku nosaukumi, cits izkārtojums vai papildu identifikatori, kas standartā neparādās tik precīzi.
Cēlonis nav modelis pats par sevi, bet dokumentu konsekvence. Ja piegādātājs katru mēnesi lieto citu veidni, vienu un to pašu zīmogu citā vietā vai rēķina tekstā iestrādā būtisko informāciju, tad vispārīgais modelis sāk strādāt mazāk precīzi. Tieši tāpēc Microsoft dokumentācija paredz iespēju papildināt noklusējuma darbību, izveidojot pielāgotu rēķinu modeli [1].
Risinājuma soļi ir praktiski un konkrēti:
- AI Builder vidē izvēlas rēķinu modeli kā sākuma punktu.
- Nosaka piegādātāja dokumentu kopu ar vienādu struktūru.
- Izveido pielāgoto modeli, lai tas atpazīst tieši šī piegādātāja lauku izvietojumu.
- Testē, vai modelis pareizi nolasa specifiskos identifikatorus un summas.
- Ja nepieciešams, pieslēdz modeli Power Automate plūsmai, lai to izmanto tikai šim piegādātājam.
Pārbaudei jānotiek uz reāliem dokumentiem, nevis tikai uz vienu ideāli noformētu piemēru. Ja pielāgotais modelis strādā, tad rēķinu procesi kļūst precīzāki tieši tajās vietās, kur standartizēts modelis līdz galam neatrisina biznesa specifiku. Tas nozīmē arī mazāk izņēmumu apstrādes pēc datu ieguves un skaidrāku ceļu uz apstiprināšanas posmu.
5. solis: definē apstiprināšanu, arhivēšanu un kontroles punktus
Tipiskā kļūda praksē ir palaist AI datu ieguvi, bet neiedot procesam noslēgumu. Dokumenti tiek nolasīti, lauki parādās sistēmā, un tad viss apstājas starpposmā: neviens nav skaidri noteicis, kurš apstiprina izņēmumu, kur rēķins tiek glabāts un kurā brīdī process skaitās pabeigts. Rēķinu procesi bez kontroles punktiem ātri pārtop par failu kaudzi ar daļēji aizpildītiem ierakstiem.
Kāpēc tas rodas? Tāpēc, ka uzmanība visbiežāk aiziet uz pašu AI modeli, nevis uz darbplūsmas beigu loģiku. Taču dokumentu apstrāde nav pabeigta, kamēr nav skaidrs, kas notiek pēc nolasa datus. Microsoft dokumentācijā rēķinu apstrādes modelis fokusējas uz galveno lauku ieguvi, tādēļ nākamais slānis jāuzbūvē pašai komandai [1].
Pareizā konfigurācija ietver trīs skaidrus posmus:
- Apstiprināšana: Power Automate plūsmā ievieto nosacījumu, kas pārbauda, vai galvenie lauki ir aizpildīti un saskan ar dokumentu. Ja nē, plūsma nosūta uz manuālu pārbaudi.
- Arhivēšana: pēc apstiprināšanas rēķinu saglabā SharePoint dokumentu bibliotēkā vai citā centralizētā repozitorijā ar vienotu nosaukšanas kārtību.
- Kontroles punkti: definē, kurā brīdī atbildīgais finanšu darbinieks saņem uzdevumu, kurā brīdī dokuments tiek atzīmēts kā pārbaudīts un kurā brīdī tas tiek nodots grāmatošanai.
Ja šos punktus neievieš, sekas redzamas ļoti ātri: izņēmumi pazūd starp komandām, atbildība kļūst neskaidra un nav iespējams izsekot, kurš posms dokumentu aizkavē. Kad kontroles punkti ir skaidri, rēķinu procesi no “datu nolasīšanas” pāriet uz pilnu dokumenta dzīves ciklu. Tieši tas noslēdz automatizācijas ķēdi un sagatavo vidi ikdienas uzturēšanai, nevis vienreizējam pilotam.
Avoti
- Rēķinu apstrādes iepriekš izveidots AI modelis. Microsoft Learn. https://learn.microsoft.com/lv-lv/ai-builder/prebuilt-invoice-processing (skatīts 30.08.2026)
- Rēķinu izrakstīšana un iepriekšēja autorizācija, izmantojot mākslīgo intelektu veselības aprūpes jomas organizācijām. Microsoft Learn. https://www.microsoft.com/lv-lv/ai/use-case/accelerate-claims-administration-with-ai (skatīts 30.08.2026)
-
AI paātrina prasību administrēšanu
Šis resurss rāda, kā AI var paātrināt dokumentu un prasību apstrādi, kas ir līdzīgi principiem rēķinu procesos. -
Rēķinu apstrāde ar SharePoint un AI Builder
Resurss skaidro, kā AI Builder palīdz automatizēt rēķinu apstrādi Microsoft 365 vidē un samazināt manuālo darbu. -
Pro forma rēķinu izveide Dynamics 365
Šis resurss apraksta pro forma rēķinu izveidi, kas ir svarīgs solis strukturētos rēķinu procesos un finanšu dokumentu apritē. -
Brīva teksta rēķinu izveide Dynamics 365 Finance
Resurss palīdz saprast, kā Dynamics 365 veidot brīva teksta rēķinus, kas papildina automatizētus rēķinu procesus uzņēmumā.
-
Microsoft 365 procesi: 10 soļi efektīvai darba gada plānošanai
Šis raksts parāda, kā rēķinu procesi iekļaujas plašākā Microsoft 365 darba plānošanā un kā standartizēti soļi palīdz sakārtot dokumentu apstrādi. Tas uzsver, ka skaidri procesi ir pamats drošai automatizācijai un vienmērīgai ieviešanai. -
SharePoint un ERP integrācija rēķinu plūsmai
Raksts ir tieši saistīts ar rēķinu procesiem, jo skaidro, kā SharePoint un ERP savienošana paātrina rēķinu apriti un samazina manuālu darbu. Tas palīdz saprast, kā AI un integrācijas var uzlabot dokumentu apstrādes drošību un precizitāti. -
Datu kvalitātes uzlabošana: kur rodas kļūdas un kā tās noķert
Datu kvalitāte ir būtiska rēķinu procesos, jo kļūdas datos var radīt nepareizu apstrādi, kavējumus un riskus audita laikā. Šis raksts palīdz noteikt, kur rodas kļūdas un kā tās savlaicīgi noķert automatizētos plūsmu scenārijos. -
Power Automate: 8 stratēģijas uzņēmumu automatizācijai
Power Automate stratēģijas ir noderīgas rēķinu procesu automatizācijā, jo tās parāda, kā veidot efektīvas un pārskatāmas darba plūsmas. Raksts palīdz saprast, kā automatizācija var samazināt manuālo ievadi un uzlabot dokumentu apstrādes kontroli.
Kā KSJ var palīdzēt
-
Answergrove: privāts AI asistents jūsu SharePoint dokumentiem
Mūsu pamatprodukts: privāts AI asistents, kas atbild no jūsu SharePoint dokumentiem un katrai atbildei norāda dokumentu, lapu un versiju. -
Pakalpojumi
Microsoft 365 un SharePoint automatizācija, ko izstrādājam un uzturam jūsu pašu tenantā.